
Robots.txt tester: como testar o robots.txt no Google, no Bing e na IA
Como testar o robots.txt depois do fim do testador antigo do Search Console: relatório de robots.txt, Inspeção de URL, testador…
Digite seu domínio e use o testador de robots.txt para ver, em segundos, o que o Google, o ChatGPT, o Claude e o Perplexity podem ler.
Grátis, sem cadastro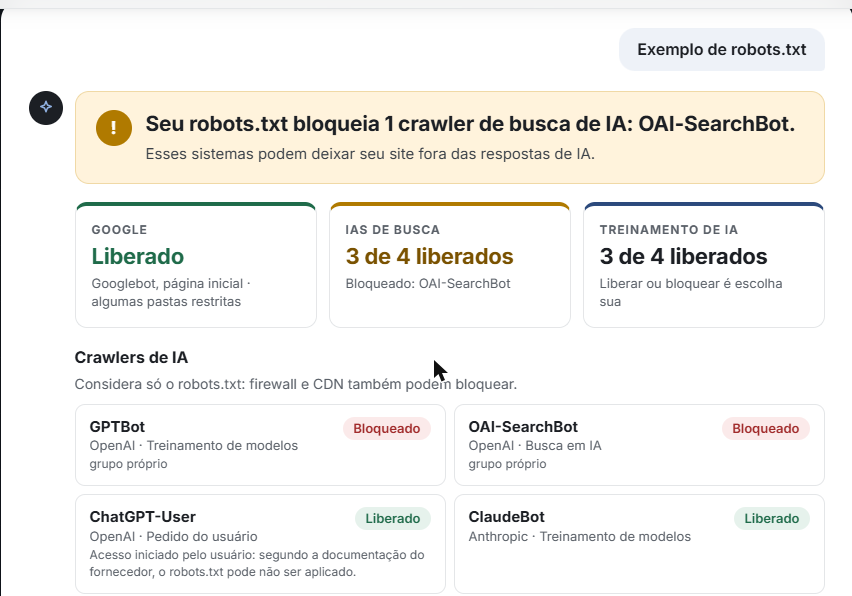
É um arquivo de texto na raiz do site que diz aos crawlers quais caminhos eles podem acessar. O Google segue essas regras ao rastrear, e os crawlers de IA, como o GPTBot e o ClaudeBot, também têm as suas.
Mas ele não serve para tirar uma página do Google: segundo a documentação do Google, para isso é preciso usar noindex ou proteger a página com senha.
User-agent: *
Disallow:User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /Quer mais modelos? Veja o modelo de robots.txt para IA.
Como testar o robots.txt depois do fim do testador antigo do Search Console: relatório de robots.txt, Inspeção de URL, testador…
Quais robôs de IA liberar e quais bloquear no robots.txt, segundo a documentação de OpenAI, Anthropic, Perplexity, Google, Apple…
Três blocos de robots.txt prontos para copiar, com o que cada um faz: liberar os robôs de IA, bloquear só o treino e bloquear os…
A lista de user agents dos robôs de IA que as próprias empresas documentam: GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot e…
O diagnóstico para quem não encontra o site no Google: como confirmar a indexação, quanto tempo esperar, os bloqueios técnicos…
As 8 causas mais comuns de a IA não citar uma marca, do robô bloqueado na Cloudflare aos dados divergentes entre site e perfis…
Em 2023 o Google substituiu o testador antigo do Search Console por um relatório de robots.txt, que mostra os arquivos encontrados, erros e avisos, mas não testa URLs. Por isso, esta ferramenta cobre essa lacuna com as regras documentadas pelo Google.
Não. É uma implementação independente, baseada na documentação pública do Google. Para ver como o Googlebot trata uma URL específica, use a Inspeção de URL do Search Console.
Não necessariamente. Segundo a OpenAI, o GPTBot coleta conteúdo que pode treinar modelos e o OAI-SearchBot define se o site aparece na busca do ChatGPT; as duas configurações são independentes. Portanto, para ficar fora da busca, o bloqueio é do OAI-SearchBot.
A Anthropic separa o ClaudeBot (treinamento), o Claude-SearchBot (busca) e o Claude-User (pedidos de usuários). O Google-Extended controla o uso do conteúdo no Gemini e não afeta a Busca do Google.
Se o servidor responde 404 ou outro 4xx (exceto 429), o Google trata como se não houvesse restrições e rastreia todo o site.
Vence a regra mais específica, a de caminho mais longo. Se as duas têm o mesmo tamanho, então vence a menos restritiva, o Allow.
Sim. Cada host tem o próprio robots.txt: blog.exemplo.com é separado de exemplo.com. Por isso, consulte um de cada vez.
Não. O robots.txt controla rastreamento, não indexação nem citação. Além disso, um firewall ou CDN também pode barrar crawlers sem deixar rastro no arquivo. Por isso, medir se a IA cita a sua marca, comparada aos concorrentes, é o trabalho da NotHuman.
Agende uma demo e veja como a sua marca aparece nas respostas de IA, com o acompanhamento de um especialista em GEO.
Agendar demoUsamos cookies necessários para o site funcionar e cookies de estatística do Google Analytics e do Microsoft Clarity para melhorar o conteúdo. Você pode recusar os de estatística; na União Europeia, no Reino Unido e na Suíça, eles só são ativados depois que você aceitar. Política de Cookies.